首页 › 工具
八个工具,一扇窗口
季节工坊的每个面板布局相同:左侧选择模型,中间描述你想要的,右侧看着它出现。学会一个就等于学会了全部八个。
下面的每个部分都回答相同的四个问题——用途、书架上需要什么、擅长什么、以及在哪里会让你失望。
文本 就绪
本地语言模型,用于工作周围的写作:初稿、更精炼的二稿、长简报的摘要、或者为还没设计好的角色列一组名字。这是你最常不知不觉打开的面板。
书架上需要什么
应用内置一个紧凑型语言模型,装好即可使用。想要更强的能力时,可以导入更大的模型——比如 80‑亿参数级别的模型。
擅长什么
- 把你的草稿句子改写成可以发出去的样子。
- 把一页笔记整理成结构化的简报。
- 批量生成变体:十个标题、十句广告语、十个角色名。
- 把一个半成品想法展开成图片面板的提示词。
哪里会让你失望
笔记本上的小模型不是研究助手。它不知道今天的新闻,要引用文献时会编造,推理能力也不如你可能已经习惯的大型云端模型。把它当作快速、私密的写作搭档,而不是全知的神谕。
翻译 就绪
专用的翻译模型,而非临时上阵的通用聊天机器人。粘贴一段文字,选择方向,得到一篇保持语体而非漂成自我解释的译文。
书架上需要什么
两种尺寸的专用翻译模型:一种跟得上打字速度,另一种用于需要细腻度的文本。两者都是磁盘上的单个文件。
擅长什么
- 主要语言对的双向段落翻译。
- 不能粘贴到网页表单中的机密材料。
- 本地化你自己的商店文案、字幕和 UI 文字。
哪里会让你失望
诗歌、文字游戏和浓重的方言仍然需要人工。稀有语言对弱于常见语言对。如果原文一团糟,译文会忠实地一团糟。
就我们自己的测试而言,这是应用中最稳定可靠的工具——如果想体验端侧推理的感觉,从这里开始最好。
图片 就绪
工坊的核心。文生图、图生图、指令编辑,采样器实时绘制预览,让你尽早放弃不满意的种子,而不是苦等整轮结束。
书架上需要什么
整个开源图片生态都可以用:SD 1.5 系列胜在速度,SDXL 和 SD 3.5 系列胜在保真度,还有更新的家庭和专用编辑模型。用一个快速模型探索,用一个重型模型出成品。
一个下午的三张图
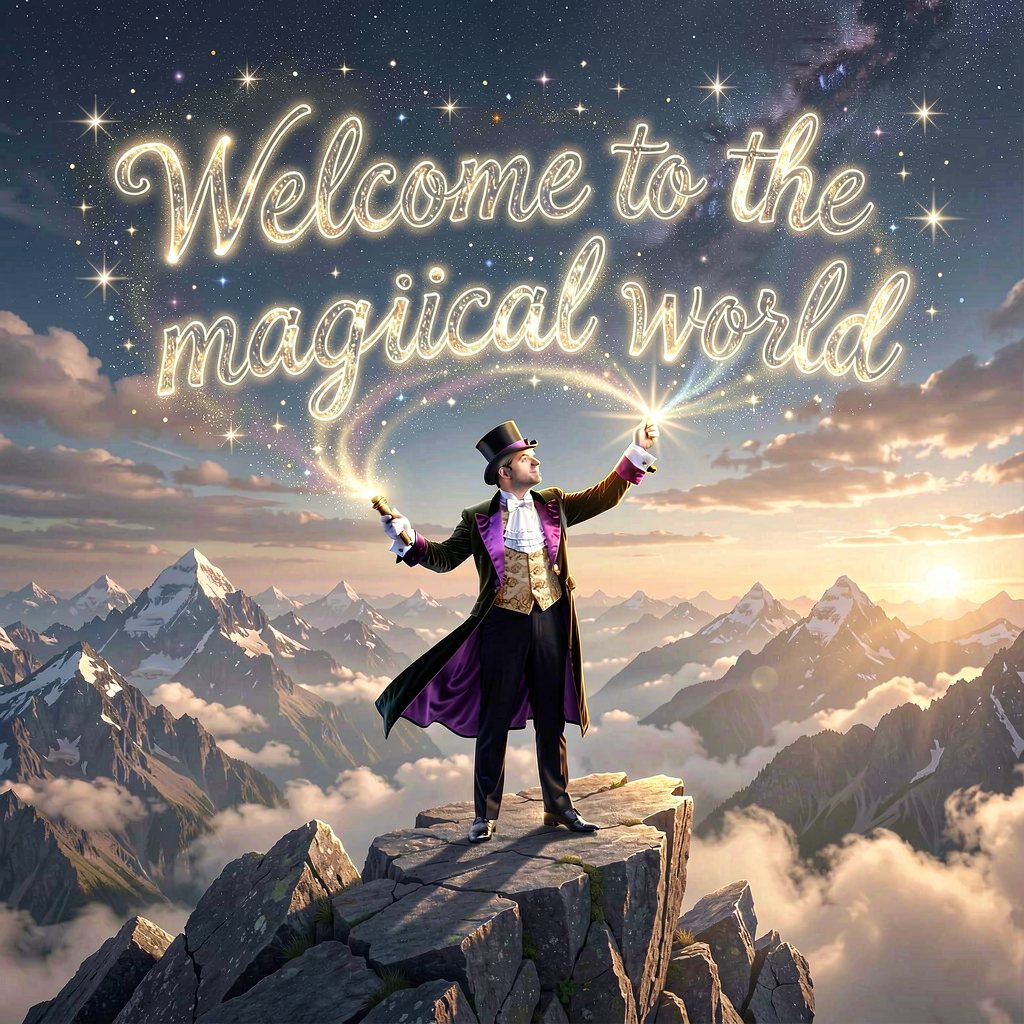
电影写实风,戏剧性轮廓光,1024×1024。
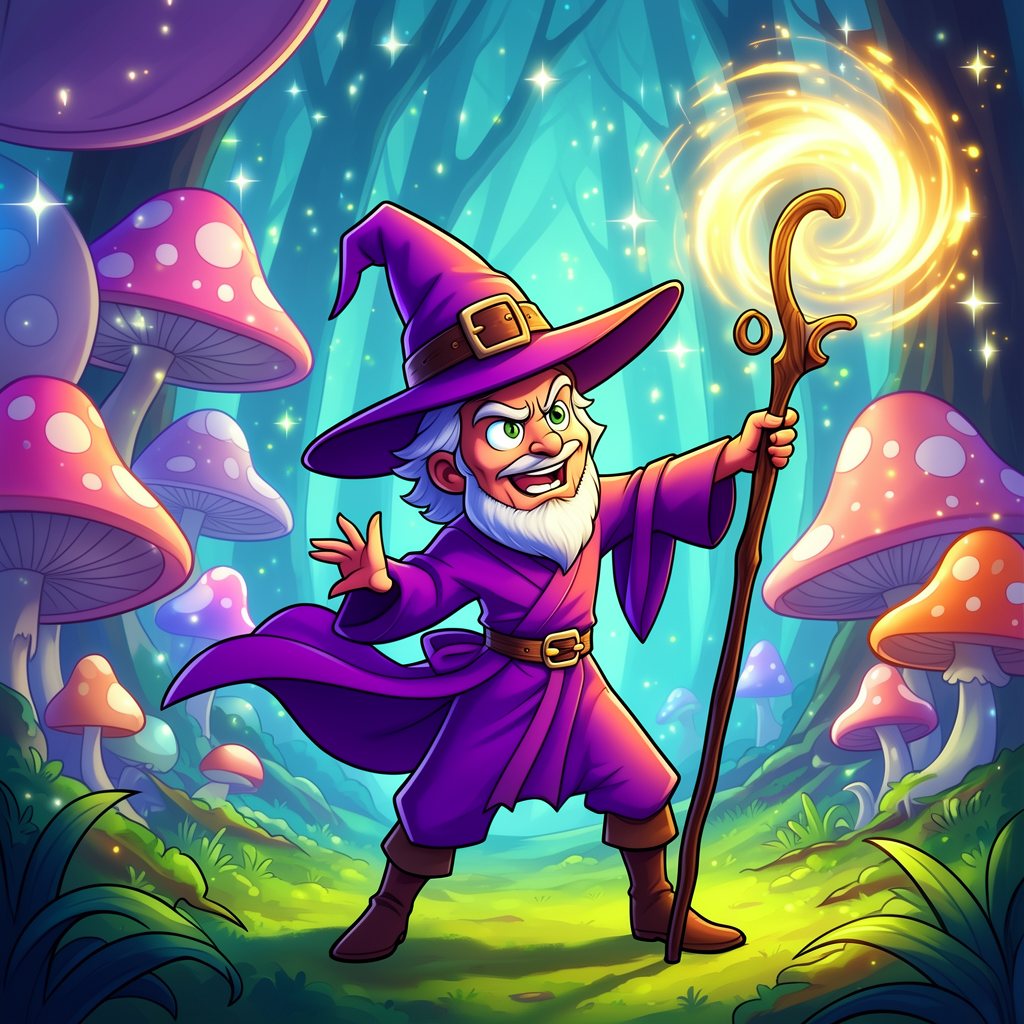
绘本水彩风,暖色调,柔和边缘。
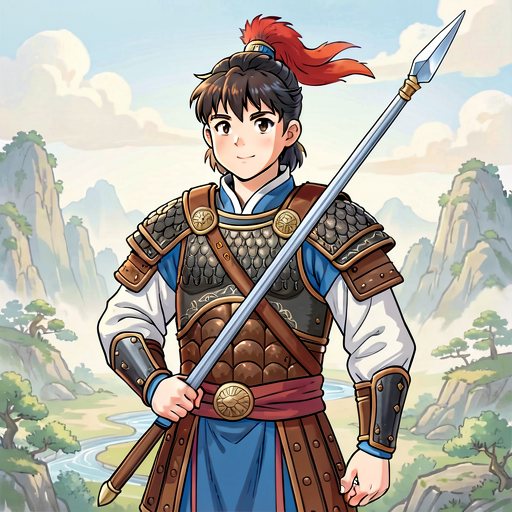
墨线平涂上色,漫画分镜构图。
- 提示词
- a robed figure alone on a mountain summit, raising a staff of light into a storm, cinematic realism, volumetric god rays, cold blue and gold
- 避免
- flat lighting, extra limbs, text, watermark
- 步数
30,引导7.0,尺寸1024 × 1024
以上三张图的占位提示词,展示格式而非要求精确复现。后续会逐模型替换为真实参数。
擅长什么
- 插画、概念艺术、主视觉和风格化角色。
- 通过图生图迭代你自己的草图。
- 局部编辑:换季节、换光线、去掉角落里的那个东西。
- 去倒杯咖啡的功夫跑一批变体。
哪里会让你失望
手、人群和长串可读文字仍然是经典的弱点。精确的构图控制——这个物体恰好在这里、恰好这个角度——仍然更容易通过画一张粗略引导图再跑图生图来实现。
视频 实验性
从一句话生成短片,或为一张你已满意的静态图添加动势。工坊中资源消耗最大的面板,也是最需要管理预期的面板。
书架上需要什么
文生视频和图生视频模型,外加一个共享的文本编码器。这是应用中最大的下载项,模型文件以 GB 计而非百 MB。
擅长什么
- 标题卡背后几秒钟的氛围动效。
- 给静态插画加上轻柔的飘动——布料、烟雾、水面、发丝。
- 氛围测试和动态分镜,粗糙可以接受的场景。
哪里会让你失望
片段很短,分辨率有限,一次渲染可能需要数分钟。角色身份在帧间会漂移,剪辑不可能,对话完全超出范围。每个可用镜头请预留多次尝试。
我们刻意将其标记为实验性。端侧视频正处于几年前图片生成所处的阶段:真实存在,偶尔惊艳,但还不足以向客户承诺交期。
音乐 早期
从描述生成声音,基于 Stable Audio 家族:一段循环、一层底色、一个短音效、一种质感。当你需要在剪辑下垫一段音乐又不想在素材库里翻一小时的时候,正好合用。
书架上需要什么
同一家族的两个方向——一个调校用于音效和短质感,一个用于音乐素材——外加一个更大的模型以获得更饱满的效果。
擅长什么
- 音效和拟音质感:雨声、一扇门、远处的集市。
- 场景或菜单界面的可循环氛围底色。
- 短音效和过渡音,几次尝试即可生成。
哪里会让你失望
不要指望一首歌。当前一代开源音频模型在完整编曲的结构上到此为止:主歌不会发展,副歌不会回归,人声不在范围内。片段长度有限,推得越远越容易跑偏。
语音转文字 就绪
丢进一段录音,得到可编辑的文字。一次访谈、一条语音备忘、一场讲座、一段获准录制的客户电话——全部在你的机器上转写。对于这个特定任务而言,这一点比任何其他面板都更重要。
书架上需要什么
多种尺寸的 Whisper 家族模型。小模型速度快、效果够用;大模型在口音和背景噪声下明显更好。
擅长什么
- 干净的人声录音,支持多种语言。
- 不能上传到任何服务的机密音频。
- 快速获取粗略转录,然后在文本面板中润色。
哪里会让你失望
说话人重叠、浓重口音、劣质麦克风和密集术语都会降低准确率。任何打算发布的内容都请预留一轮人工校对。
文字转语音 就绪
给一段文字一个声音。用预设声音朗读一段话,用自然语言描述你想要的声音,或者在一组尝试中保持同一个声音一致。
书架上需要什么
基础、自定义声音和声音描述三种变体,两种尺寸。最有趣的是描述变体:你写下声音应该听起来像什么,而不用在列表里翻找。
擅长什么
- 演示视频、预告片或原型的旁白。
- 游戏或动画还在制作时的临时配音。
- 把自己的文案听一遍,能很快发现拗口的句子。
哪里会让你失望
很长的段落韵律会漂移,所以把脚本切成段落。细腻的情感控制仍然粗糙。还有一个值得直说的点:未经同意克隆真人的声音不是我们支持的使用方式。
视觉 就绪
唯一一个读取而非写入的面板。给它一张图片,问它里面有什么:一段描述、招牌上的文字、物体周围的框、或者你想抠出的主体的轮廓。
书架上需要什么
一组紧凑型视觉模型而非一个大模型:OCR、分类、检测、分割、人脸关键点和属性。它们体积小、加载快,其中一部分随应用内置。
擅长什么
- 给一组图片加描述,方便日后搜索。
- 从截图、扫描件或拍照页面中提取文字。
- 在图生图之前找到并勾出主体。
- 按每张照片的实际内容分类一批拍摄素材。
哪里会让你失望
手写体、美术字体和低分辨率扫描会降低 OCR 准确率。检测基于固定的类别词表,不常见的主体会返回最接近的猜测。人脸属性是近似值,我们更希望你不要把它当作关于一个人的事实。